毛孩重逢
上傳照片、寫下想對牠說的話,AI 做一支和離開的毛孩重逢的影片。
痛點
毛孩離開之後,留下來的只有照片。照片會褪色成回憶,但不會動、不會跑回你身邊。
市面上已經有 AI 擁抱模板、寵物照片動畫,試過之後會發現兩個問題:
- 長得不像。 AI 只看一張照片就生成,換個角度花色就跑掉,認不出是自己的那隻。
- 故事不是你的。 模板寫好了固定的劇情——擁抱、轉圈、結束。你想看的那個畫面,那個只有你們知道的場景,放不進去。
為什麼要寫這個
我想做一個不收費、不商業化的地方,讓想念毛孩的人可以用自己的照片、自己的話,再見牠一面。
重點不在於技術多新,而在於兩件事要做對:牠要長得像,故事要是你自己的。
解決了我什麼需求
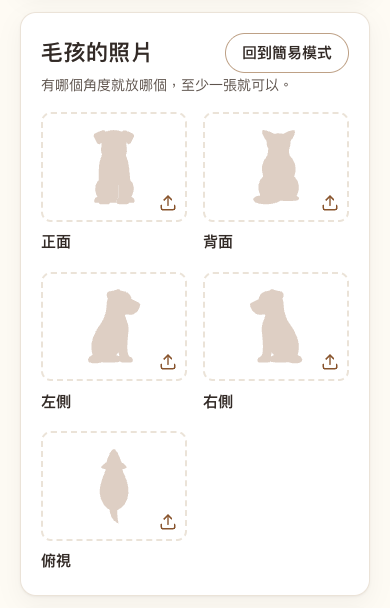
- 讓毛孩長得像。 可以上傳最多五個角度的照片(正面、背面、左右側、俯視),系統先整理成一張多角度設計圖,再拿它生成影片,花色與體型才對得上。
- 讓故事照你說的走。 你用口述寫下想看到的畫面(例如「旺來從花草堆竄出來」),AI 當導演規劃鏡頭清單——哪張場景照用在哪個鏡頭、多長、什麼運鏡。
- 讓你有最後決定權。 AI 寫好的劇本可以逐句改、拖動排序、新增刪除鏡頭,確認了才開始製作。
實際功能展示
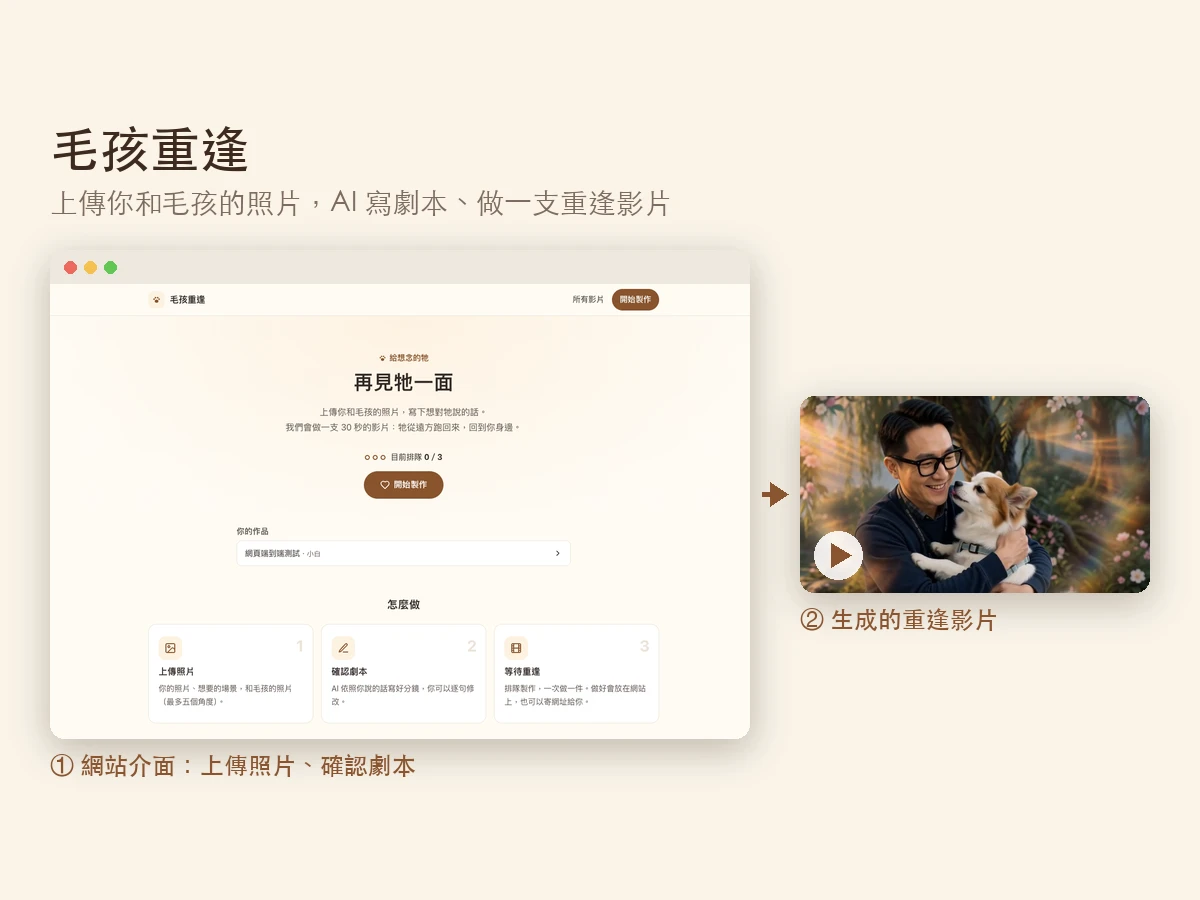
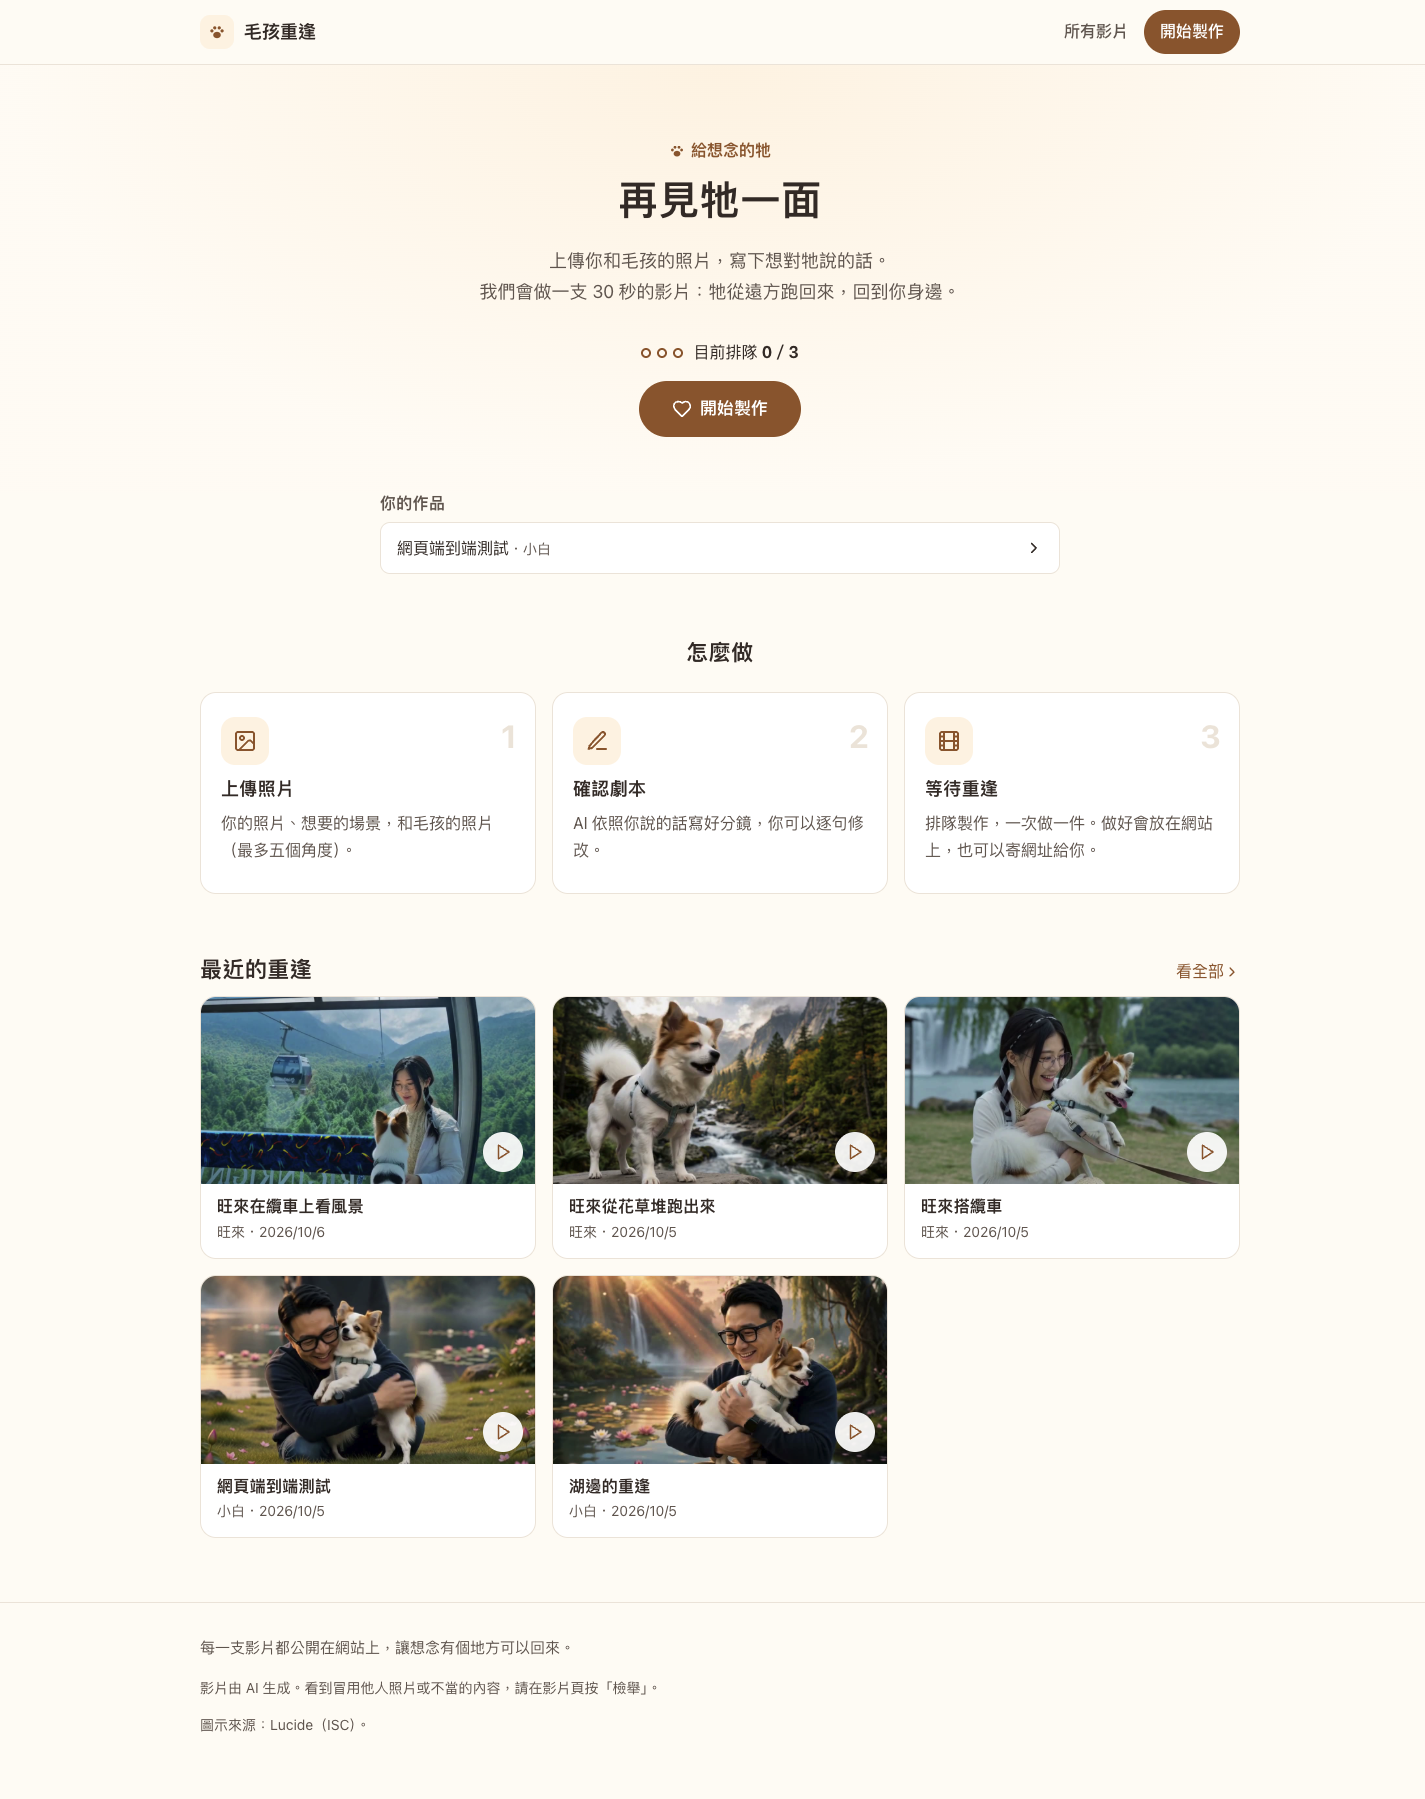
首頁一句話說明三個步驟:上傳照片、確認劇本、等待重逢。版面以手機優先設計(大部分人是拿手機翻相簿上傳的),桌面版同樣一眼看完。
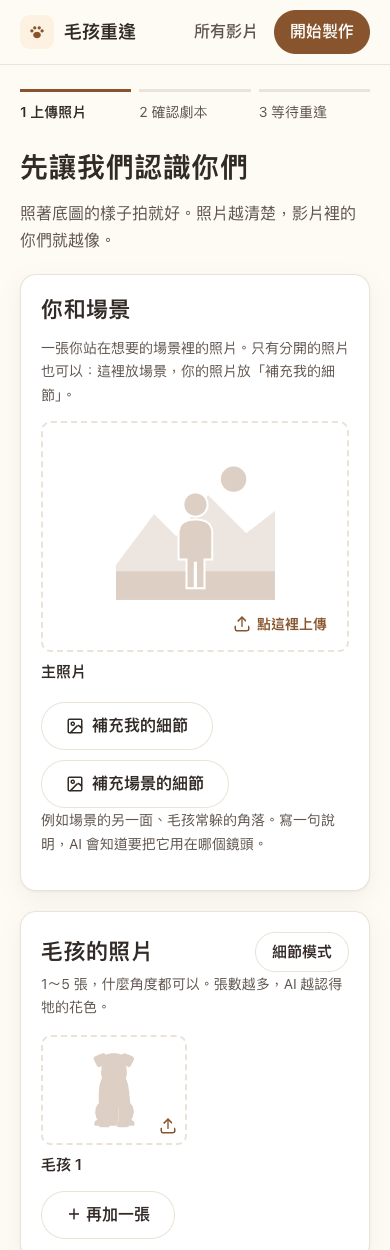
上傳頁的每個框都有一張淡淡的剪影示範圖,像證件照上傳頁那樣,告訴你該放什麼樣的照片:
切到「細節模式」就分成五個角度的格子,每格的剪影就是那個角度的同一隻狗:
做好的影片直接公開在網站上,可以回來找,也可以留 Email 收網址:
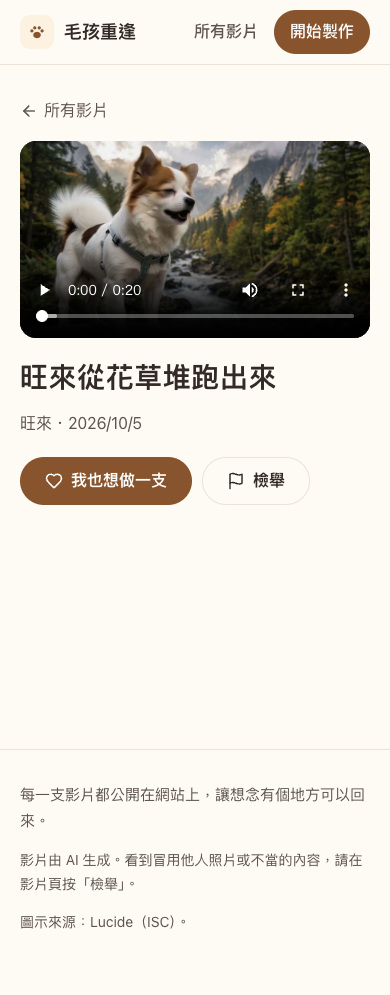
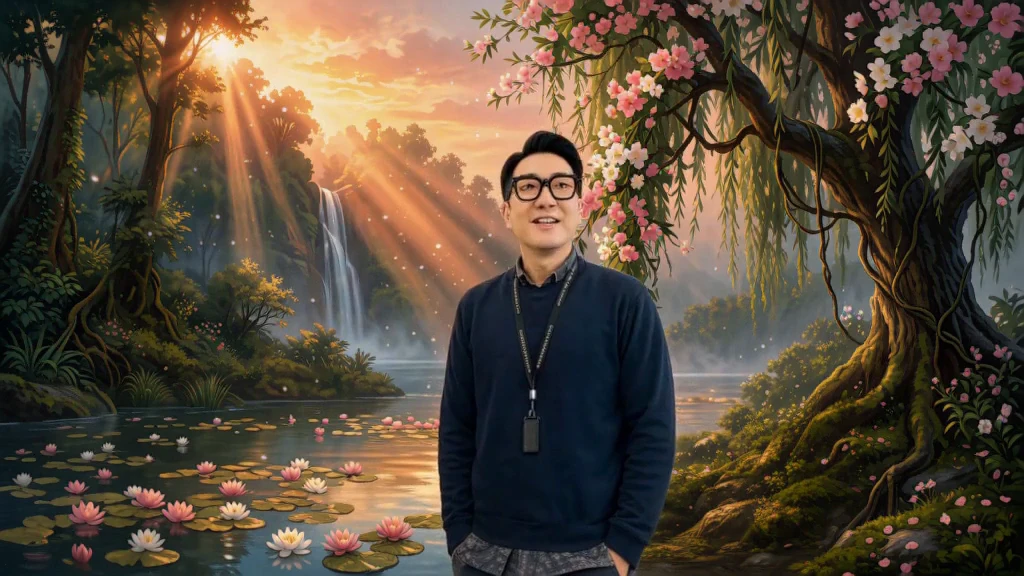
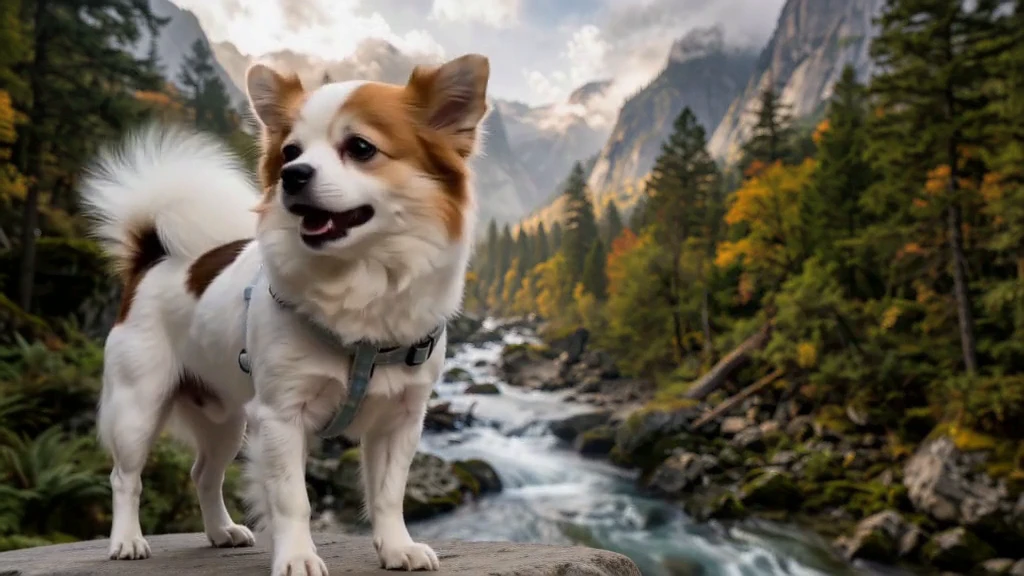
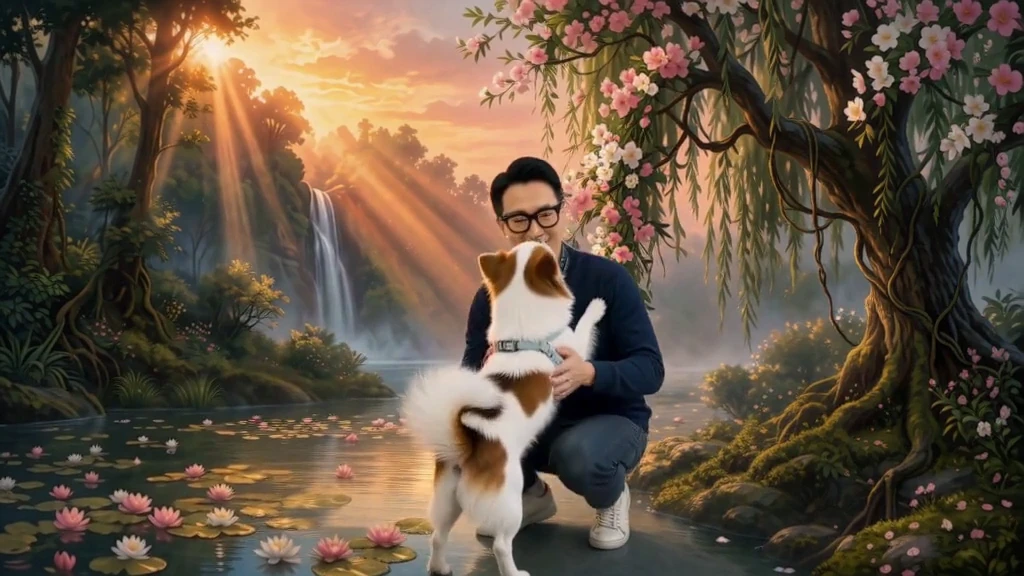
這是實際生成的一支成片(20 秒、3 段),標題是「旺來從花草堆跑出來」。AI 把它排成三段:主人在湖邊等待、旺來在山溪邊出現、跑回主人身邊。
技術做法
AI 當導演,但劇本格式寫死。 LLM 讀照片與口述,回傳一份固定格式的鏡頭清單(場景照、長度、景別、運鏡、畫面、台詞)。審核頁照這份清單排版,系統再依「同一個場景接在一起」自動切成段落,每段長度與台詞字數都有上限,超過就標紅、不能送出。
一次一件的生成流水線。 確認之後進排隊(上限 3 件,公開顯示),背景工作者照順序做:去背 → 畫多角度設計圖 → 每一段先合成開頭畫面 → 生成影片 → 接片。每一步都有檢查點,機器重開也能從斷掉的地方接回去。實測一支 20 秒、3 段的影片要 24.8 分鐘,系統事前估 25.1 分鐘。
段落之間接得順。 同一個場景的下一段,用前一段的動態當參考接續生成,交界處的畫面跳動跟段落內部差不多;換場景的地方則刻意硬切。
毛孩只能出現一隻。 把多張毛孩照片分開餵給生圖模型,畫面裡會冒出兩隻狗。改成先把所有角度拼成一張多角度設計圖再送,才穩定只有一隻、花色正確。
後台從網路上根本連不到。 公開站與後台是同一支程式的兩個埠,對外只轉發公開站那一個,後台只聽本機——所以不需要帳號密碼也不會被打。
網站跑在 Mac mini 上,生成工作交給區網裡另一台有 GPU 的機器上的 ComfyUI。目前在自己的機器上運作,還沒對外開放。